Posts Tagged with "Design"

既に発行済みのブログであっても適宜修正・追加することがあります。
We may make changes and additions to blogs already published.
posted by sakurai on September 24, 2026 #1129

まとめ

同じPCで、bsc 2025.07のコンパイル時間と、Vivado 2026.1で論理合成した結果を、描画のmodule化前後で比べます。前は8/3版、後は教科書版です。論理合成はArty A7のトップからのフラット合成で、階層別レポートからmkGameFSMの値を読みました。ソース行数はGameFSM.bsvとBlitter.bsvの合計、VerilogはmkGameFSM.vとmkBlitter.vの合計です。抑止した警告数は、前がG0036とG0010、後がそれにG0009を加えた数で、8/3版にG0009は出ません。合成対象は前後ともsvnのリビジョンで固定し、生成Verilogのmd5でWindowsへ渡した実物を照合しました。

描画モジュール化前後 前 後 比較
BSV合成 ソース行数[行] 1,878 1,889 0.6%増
コンパイル時間 0:51 0:29 ▲44%
抑止した警告数 1,734 451 ▲74%
生成Verilog行数[行] 47,117 32,845 ▲30%
Verilog合成 合成時間(トップ全体) 1:10 1:11 ほぼ同じ
Vivado LUT数 5,352 4,977 ▲7.0%
Vivado FF数 1,919 1,935 0.8%増

表の各行はmkGameFSMとmkBlitterの範囲の値です。ただし合成時間だけはトップ全体の値で、フラット合成ではmkGameFSMの合成時間を単独に取り出せないためです。母数が他の行と異なる点に注意が要ります。

コンパイル時間を決める構造で見ると、前後の差はBlitterのmodule化だけです。前の版は既にRUN_FSMマクロによる切り出しを済ませており、描画の実体をmkFSMで1本に集約した状態です。後の版はその集約したBlitterを、ヒット判定まで含めて独立したmoduleに出しています。

効果はbscのコンパイル時間に集中しています。ソース行数はほぼ同じで、同じ量を書いてコンパイルが半分になりました。生成Verilogが30%減り、抑止した警告が4分の1になったのは、GameFSM側から描画とヒット判定の展開が消えた分です。

物量はLUTが7.0%減、FFが0.8%増です。モジュール化そのものは規則とレジスタの置き場所を変えるだけで論理を変えないので、物量を減らす理由を持ちません。むしろmkBlitterの境界に置いたkickとlaunchの規則、RWire、goレジスタの分だけ増える方向で、FFの0.8%増がそれです。LUTが減ったのは、前後の間に入った他の改変の効果です。2点目の呼び出し形の変更と4点目のFSM切り出しで各FSMの状態が合計418から338に減り、80状態ぶんの状態デコードと遷移条件の論理が消えました。またブリッタの矩形4種のループを1組に統合し、gfx_fsmの47状態が22になって、4種それぞれが持っていたループ制御とカウンタ更新の論理が1組に共有されました。減り方が小さいのは、減ったのが状態機械の制御部分だけで、各状態の中で行う描画や判定やゲームロジックの計算は8/3版と同じだからです。論理合成時間は動きません。

コンパイル時間が縮む機序は、ステート干渉チェックの境界での打ち切りです。同一ソースにあるとき、bscはBlitterの状態とGameFSMの状態を一緒くたに解析し、すべての状態間・ルール間の干渉を調べます。module化すると、Blitter内の解析はモジュール境界で閉じ、GameFSM側から見えなくなります。GameFSMが解析する状態空間が小さくなり、その分の解析時間が消えます。抑止した警告の数が4分の1になったことが、解析対象の縮小を裏付けます。

FFがわずかに増えるのは、module境界のインタフェースレジスタの分です。起動コマンドをRWireに載せて1サイクル後にFSMを起動する形にしたため、引数のラッチと完了・判定の戻りがレジスタとして加わりました。この1サイクルの遅延はmodule化の実行時の代償で、描画1回あたり1サイクルです。

記事#1028の改良は、呼び出しごとに展開されていた描画ループを1個のサブFSMの再利用に変え、コンパイル時間を87%減らしました。記事#1035から記事#1039は、同じRUN_FSMでdrawLivesと、本体の厚いupdateAlienBullet、updatePlayerBullet、initAllを順に切り出し、1分54秒を54秒まで縮めました。

今回の改良は、ブリッタをモジュールの境界で包んだもので、bscのコンパイル時間を同じPCで51秒から29秒に、44%減らしました。3段階とも主眼はbscのコンパイル時間で、物量は付随して動きます。LUTは各段階で減り、記事#1028で18%、記事#1037から記事#1039で3%、今回で7.0%です。FFは記事#1028で0.5%減ったあと、記事#1037から記事#1039で7%、今回で0.8%増えました。seqをFSMに切り出すたびに状態レジスタと引数のラッチが増えるためで、FSM化はFFを増やす方向に働きます。


左矢前のブログ 次のブログ右矢

posted by sakurai on September 22, 2026 #1127

4. 1箇所からしか呼ばれないseqのFSM化

seqをFSMに切り出す第一の理由は再利用で、記事#1035のdrawLivesがそれです。6箇所から呼ばれるseqを1個のFSMにまとめ、コンパイル時間を25%減らしました。記事#1036からは別の狙いで、1箇所からしか呼ばれないseqでも巨大なメインのseqから外せば競合条件の計算量が減るはず、という試みが始まります。記事#1036のdrawTitle1は1度しか呼ばれず本体も薄く、コンパイル時間が1%しか動かなかったので撤回されました。記事#1037のupdateAlienBulletと記事#1038のupdatePlayerBulletは本体が厚く、コンパイル時間がそれぞれ14%と16%、Verilogが11%と19%減って採用され、記事#1039のinitAllも同様に採用されました。つまり効くかどうかは呼び出し回数ではなく本体の厚さで決まる、というところまでが8/3版の時点で分かっていました。

ここではその続きとして、同じ基準で残っていたupdateAliens、updatePlayer、updateSaucerの3つをFSMにしました。本体の厚いseqはメインから切り出す方がbscの負担が軽い、という記事#1037と記事#1038で見えていた傾向に従ったものです。動作はVRAM書き込みの系列がサイクル番号を除いて一致しました。

教科書版の最終形

以上から、教科書版は次の2つの基準で決めました。複数箇所から呼ばれるseqは、共有するためにFSM化します。1個のインスタンスを作り、RUN_FSMマクロで各所から呼びます。メインループから呼ぶ大きなseqは、1箇所からしか呼ばれなくても、メインを小さくするためにFSM化します。仕組みは同じで、動機が違います。前者は規則の複製を消し、後者はメインFSMの状態数を減らします。モジュール境界は、42箇所から呼ばれ自前のレジスタを持つブリッタだけに使います。

seq 呼び出し箇所 扱い 置き場所
copyAreaなど描画プリミティブ6種 42 共有するためのFSM化 mkBlitter
drawLives 6 共有するためのFSM化 メイン
waitTicks 4 共有するためのFSM化 メイン
initAll 2 共有するためのFSM化 メイン
drawScores 2 共有するためのFSM化 メイン
updateAliens、updatePlayer、updatePlayerBullet、updateAlienBullet、updateSaucer 各1 メインを小さくするためのFSM化 メイン
updateBonus、checkClear、erasePlayerBulletなど小さなseq 1から5 展開のまま メイン

FSMはmkBlitterの1個とメインの9個で、メインループは各サブシステムのFSMをstartしてdoneを待つだけの短い列になります。教科書版の各FSMの状態数は次のとおりです。

FSM 状態数
メイン 90
updatePlayerBullet_fsm 54
updateSaucer_fsm 36
updateAlienBullet_fsm 33
updatePlayer_fsm 30
initAll_fsm 22
blit_fsm、mkBlitterの中 22
drawScores_fsm 18
updateAliens_fsm 18
drawLives_fsm 9
wt_fsm 6
合計 338

メインFSMの状態数は8/3版の193から90になりました。FSM全体の合計では、8/3版の418から338です。コンパイル時間と物量の前後は記事#1129の表にまとめます。


左矢前のブログ 次のブログ右矢

posted by sakurai on September 21, 2026 #1126

3. モジュール化

8/3版では、ブリッタが使う作業レジスタと画面メモリ側のレジスタが全部メインモジュールの中で宣言されていました。メインのどの規則からも読み書きできるので、実質はグローバル変数です。

書き換え前、mkGameFSMの中

Reg#(PAddr_t) p_addr <- mkRegU;
Reg#(VAddr_t) v_addr <- mkRegU;

Reg#(Bool) fvwe <- mkReg(False),
           fwen <- mkReg(False),
           fgunexp <- mkReg(False),
           fbullet <- mkReg(False),
           fobj <- mkReg(False),
           fbase <- mkReg(False),
    fempty  <- mkReg(False),
           fhit_alien <- mkReg(False);

Reg#(SoundCode_t) inscode <- mkRegU;
Reg#(Pattern_t) vd <- mkRegU;
Wire#(Pattern_t) vdata <- mkWire,
                 romdata <- mkWire;
Wire#(UInt#(3)) dipsw <- mkWire;

Reg#(UInt#(9)) xs <- mkRegU,
               ys <- mkRegU,
               xd <- mkRegU,
 yd <- mkRegU;
method Action pdin(Pattern_t in_romdata);
   romdata <= in_romdata;
endmethod
method Action vdin(Pattern_t in_vdata);
   vdata <= in_vdata;
endmethod
method PAddr_t prom_addr();
   return p_addr;
endmethod
method VAddr_t vaddr();
   return v_addr;
endmethod
method Bool vwe();
   return fvwe;
endmethod
method Pattern_t vdout();
   return vd;
endmethod

書き換え後、Blitter.bsvのmkBlitterの中

// MemPort: 画面メモリ側の面
interface MemPort;
   (* always_ready *) method PAddr_t   prom_addr;
   (* always_ready *) method VAddr_t   vaddr;
   (* always_ready *) method Bool      vwe;
   (* always_ready *) method Pattern_t vdout;
   (* always_enabled *) method Action pdin(Pattern_t d);
   (* always_enabled *) method Action vdin(Pattern_t d);
endinterface

interface Blitter_ifc;
   interface BlitPort port;
   interface MemPort  mem;
endinterface

(* synthesize *)
module mkBlitter(Blitter_ifc);

   Reg#(PAddr_t) p_addr <- mkRegU;
   Reg#(VAddr_t) v_addr <- mkRegU;
   Reg#(Bool) fvwe <- mkReg(False),
              fobj <- mkReg(False),
              fbase <- mkReg(False);
   Reg#(Pattern_t) vd <- mkRegU;
   Wire#(Pattern_t) vdata <- mkWire,
                    romdata <- mkWire;
   Reg#(UInt#(9)) xs <- mkRegU,
                  ys <- mkRegU,
                  xd <- mkRegU,
                  yd <- mkRegU;
interface MemPort mem;
   method PAddr_t   prom_addr = p_addr;
   method VAddr_t   vaddr     = v_addr;
   method Bool      vwe       = fvwe;
   method Pattern_t vdout     = vd;
   method Action pdin(Pattern_t d); romdata <= d; endmethod
   method Action vdin(Pattern_t d); vdata   <= d; endmethod
endinterface

書き換え後、mkGameFSMの中

Blitter_ifc blt <- mkBlitter;
method Action pdin(Pattern_t in_romdata);
   blt.mem.pdin(in_romdata);
endmethod
method Action vdin(Pattern_t in_vdata);
   blt.mem.vdin(in_vdata);
endmethod
method PAddr_t prom_addr();
   return blt.mem.prom_addr;
endmethod
method VAddr_t vaddr();
   return blt.mem.vaddr;
endmethod
method Bool vwe();
   return blt.mem.vwe;
endmethod
method Pattern_t vdout();
   return blt.mem.vdout;
endmethod

レジスタの宣言は一字も変わらず、置き場所だけがmkBlitterに移りました。名前はインタフェースに現れないので、メインからは触れません。これがBSVにおけるローカル変数の実体で、関数の中で実行時の状態を持つ手段が無いため、状態の局所化はモジュールの単位で行います。mkBlitterに入れたのは、VRAMとPROMのアドレスを出してデータを読み書きする部分です。矩形転送の本体と、自弾や敵弾の進路のVRAMを読むヒット判定がそれで、MemPortに出ているprom_addr、vaddr、vwe、vdout、pdin、vdinを駆動する機構がここにあります。drawLivesやdrawScoresは、copyAreaやeraseAreaを呼ぶだけで自分ではアドレスを出さないので、ゲームロジックとしてメインに残しています。

ここで、2点目のRUN_FSMマクロによる切り出しと、3点目のモジュール化の違いを押さえておきます。マクロで包むと、ブリッタの中身は人間から見えなくなります。人間はFSMが1個ずつしか動かないことを知っているので、呼び出し側の完了待ちだけを見れば中身は気にしなくてよい、と判断できます。ところがbscはその仮定を知りません。マクロは展開されてメインFSMの文に戻り、gfx_fsmも作業レジスタもmkGameFSMの中にあるままなので、bscは全部の規則の間で読み書きの順序を総当たりで調べます。マクロで切り出すとインライン展開が消えて規則の総数は減りますが、残った規則どうしの総当たりは続きます。8/3版で警告が1,734件出ていたのはそのためです。

モジュール化は、この総当たりの範囲を境界で切ります。mkBlitterに移した規則とレジスタは、mkGameFSMをコンパイルするときの解析対象から外れ、bscが見るのはblt.portのstartとdoneだけになります。総当たりの計算量は規則の数の2乗のオーダーで増えるので、規則の総数が同じでも、範囲を2つに分ければ組の数は大きく減ります。マクロ化は規則の数を減らし、モジュール化は総当たりの範囲を切る、と対比できます。人間から見えなくするのがマクロ化、コンパイラから見えなくするのがモジュール化です。

物量への効果は、この段階だけを取り出すと2点目に書いた状態数の削減と同じもので、モジュールの境界そのものはLUTを増やしも減らしもしません。モジュール化が効いたのは別の2点です。

一つはコンパイル時間で、bscのスケジューラはメインの規則とブリッタの規則の組を調べなくなり、mkBlitterは独立に数秒でコンパイルされます。抑止した警告の数がそれを裏付けます。8/3版はG0036とG0010で1,734件でした。教科書版ではG0036が127件、G0010が318件に減ります。加えて教科書版ではG0009が出ます。別のFSMの状態どうしが同じレジスタを読み書きして順序の循環ができ、bscがその組をconflictにして循環を切った、という警告で、FSMは1個ずつしか動かないので実害はありません。G0036、G0010と同じ根拠で抑止します。教科書版ではこの循環を順に解消し、G0009は6件です。合計は1,734件から451件になりました。コンパイル時間の前後は記事#1129の表にまとめます。

もう一つは、ブリッタが独立したことで内部の整理がしやすくなったことで、矩形4種のループを1組に統合しました。画素ごとの書き込み値だけが違うので、その部分だけをcaseに閉じ込めました。

action
   case (b.op)
      BLIT_COPY:  vd <= romdata;
      BLIT_OR:    vd <= vdata | romdata;
      BLIT_ANDN:  vd <= vdata & ~romdata;
      BLIT_ERASE: vd <= 0;
   endcase
   xs <= xs + 1;
   xd <= xd + 1;
endaction

ブリッタ部分の規則数は8/3版の37から教科書版の14に減りました。規則数は、生成Verilogの中でWILL_FIRE_RLの信号として現れる規則の数です。8/3版はmkGameFSMの中のgfx_fsmに属する規則、教科書版はmkBlitter全体の規則を数えました。


左矢前のブログ 次のブログ右矢

posted by sakurai on September 20, 2026 #1125

2. サブFSMの起動

サブFSMを1個だけインスタンスし、呼び出し側はstartとdoneだけを触る、という構造は8/3版と同じです。RUN_FSMマクロも、メインに置くwt_fsmやinitAll_fsmなど9個のFSMでは今も使っています。変わったのはブリッタの呼び方で、引数のラッチと起動が呼び出し側の2つの文からモジュールの中に移りました。

書き換え前

Reg#(Blit) blit_arg      <- mkReg(Blit{
  op:  BLIT_COPY,   // 無難なデフォルト
  sx:  0,  sy:  0,
  dx:  0,  dy:  0,
  w:   0,  h:   0,
  col: 0
});   // blit 用の引数保持レジスタ

FSM gfx_fsm <- mkFSM(blit(blit_arg));

// RUN_FSM: サブFSM 起動マクロ(start → done 待ち)。seq - endseq 内で呼ぶこと
`define RUN_FSM(F) action F.start(); endaction await(F.done);

// runBlit: gfx_fsm の起動ラッパ
//   引数を blit_arg にラッチしてから gfx_fsm を start し、done を待つ。
function Stmt runBlit(Blit b);
  return (seq
    action blit_arg <= b; endaction
      seq
        `RUN_FSM(gfx_fsm)   // start→done
      endseq
  endseq);
endfunction // runBlit

  function Stmt copyArea(U8 sx, U8 sy, U8 dx, U8 dy, U9 w, U9 h);
    return runBlit(Blit{op:BLIT_COPY, sx:sx, sy:sy, dx:dx, dy:dy, w:w, h:h, col:0});
  endfunction // copyArea

書き換え後、Blitter.bsv側

// BlitPort: ブリッタの利用者に見せる面
interface BlitPort;
   method Action start(Blit b);     // コマンド投入(1 サイクル後に FSM 起動)
   method Bool   done;              // 完了(コマンド未投入時も True)
   method Bool   obj;               // 直前の VDOTS/HDOTS でスプライト画素あり
   method Bool   base;              // 直前の VDOTS/HDOTS でシールド画素あり
endinterface

// runBlitOn と同名ラッパ群の On 版: BlitPort を第 1 引数に取る。
// 各モジュールでは let copyArea = copyAreaOn(port); のように部分適用して使う。
function Stmt runBlitOn(BlitPort p, Blit b);
  return (seq
    p.start(b);
    await(p.done);
  endseq);
endfunction // runBlitOn
function Stmt copyAreaOn(BlitPort p, U8 sx, U8 sy, U8 dx, U8 dy, U9 w, U9 h);
  return runBlitOn(p, Blit{op:BLIT_COPY, sx:sx, sy:sy, dx:dx, dy:dy, w:w, h:h, col:0});
endfunction // copyAreaOn
FSM blit_fsm <- mkFSM(blitDispatch(blit_arg));

   // ---- ブリッタの起動 ----
   // port.start はコマンドを RWire に載せるだけで、同じサイクルに kick が引数を
   // blit_arg にラッチし、次のサイクルに launch が blit_fsm を起動する。
   // 元の runBlit(引数ラッチ → start → done 待ち)と同じサイクル数になる。
   Reg#(Bool)   go  <- mkReg(False);
   RWire#(Blit) cmd <- mkRWire;

   rule kick (cmd.wget matches tagged Valid .b);
      blit_arg <= b;
      go <= True;
   endrule

   rule launch (go);
      go <= False;
      blit_fsm.start;
   endrule

   interface BlitPort port;
      method Action start(Blit b) if (!go && blit_fsm.done);
         cmd.wset(b);
      endmethod
      method Bool done  = !go && blit_fsm.done;
      method Bool obj   = fobj;
      method Bool base  = fbase;
   endinterface

書き換え後、GameFSM.bsv側

 Blitter_ifc blt <- mkBlitter;

// 原実装と同名の薄ラッパ群: Blitter.bsv の On 版に blt.port を部分適用
let copyArea    = copyAreaOn(blt.port);
let orArea      = orAreaOn(blt.port);
let eraseArea   = eraseAreaOn(blt.port);
let eraseAreaSP = eraseAreaSPOn(blt.port);
let readVdots   = readVdotsOn(blt.port);
let readHdots   = readHdotsOn(blt.port);

呼び出し箇所のcopyAreaの書き方は変わりません。変わるのは展開結果で、8/3版では呼び出し1箇所が「ラッチ、start、await」の3状態に展開されていたのが、教科書版では「start、await」の2状態になります。ラッチと起動の2サイクルはモジュールの中のkickとlaunchが担うので、動作のサイクル数は同じです。Verilatorで1,000万サイクルのVRAM書き込み系列を比べ、サイクル単位で一致することを確認しました。

生成Verilogで見ると、呼び出し箇所の規則はこう変わります。書き換え前は1箇所につきラッチの規則とawaitの規則が別々にあります。

// rule RL_action_l731c20_12       ← blit_arg <= b のラッチ
assign WILL_FIRE_RL_action_l731c20_12 =
    NOT_wt_fsm_jj_repeat_count_read__86_EQ_0_87_88_ETC___d895 &&
    !wt_fsm_start_reg &&
    state_mkFSMstate == 8'd46 ;

// rule RL_action_l731c59_9        ← await(gfx_fsm.done)
assign WILL_FIRE_RL_action_l731c59_9 =
    blit_arg_2_BITS_56_TO_54_3_EQ_0_4_AND_gfx_fsm__ETC___d954 &&
    state_mkFSMstate == 8'd43 ;

書き換え後はstartの規則とawaitの規則だけで、doneはモジュールの出力ポート1本になります。

// rule RL_action_l55c6_1          ← blt.port.start(b)
assign WILL_FIRE_RL_action_l55c6_1 =
    blt$RDY_port_start && str_idx_129_ULT_24___d5130 &&
    (state_mkFSMstate == 7'd3 || state_mkFSMstate == 7'd6) ;

// rule RL_action_l56c10_1         ← await(blt.port.done)
assign WILL_FIRE_RL_action_l56c10_1 =
    blt$port_done && state_mkFSMstate == 7'd4 ;

8/3版と教科書版で、各FSMの状態数は次のように変わりました。状態数は、生成Verilogの中で状態レジスタとの比較に現れる値の種類を数えたものです。教科書版の値には、4点目でメインからupdateAliens、updatePlayer、updateSaucerを切り出した効果と、3点目でブリッタの矩形4種のループを1組に統合した効果も含みます。教科書版ではgfx_fsmをblit_fsmに改名し、mkBlitterの中に置いています。

FSM 8/3版 教科書版 比較
メイン 193 90 ▲103
updatePlayerBullet_fsm 64 54 ▲10
updateAlienBullet_fsm 41 33 ▲8
initAll_fsm 28 22 ▲6
drawLives_fsm 13 9 ▲4
drawScores_fsm 26 18 ▲8
gfx_fsm、教科書版ではblit_fsm 47 22 ▲25

メリットをまとめると、呼び出し側からblit_argとgfx_fsmが消えてstartとdoneだけを見ればよくなったこと、そして呼び出し箇所ごとの状態が1つ減ったこと、の2つです。


左矢前のブログ 次のブログ右矢

posted by sakurai on September 19, 2026 #1124

ChatGPT版との差分3点

比較の前は8/3版で、記事#1026から記事#1028でChatGPTが描画関数を1個のサブFSMにまとめてstartとdoneで呼ぶ形にし、そのとき作ったRUN_FSMマクロを使って記事#1035から記事#1039でdrawLives、updateAlienBullet、updatePlayerBullet、initAllを順にFSMにした状態を指します。Claude版はその構造を保ったまま3箇所を書き換え、その上で記事#1035から記事#1039のFSM化を残りのseqに進めたものを4点目としました。以下、各点について書き換え前後のコードと、生成Verilogで確認できる差を示します。数値は、bscのコンパイル時間とVivado 2026.1のxc7a35t向けOOC合成結果を同じPCで測ったもので、LUTとFFにYosysと断ったものは手元の概算です。コードは教科書版に揃えてあります。

1. 文字列テーブル

ChatGPT版はビット連接でBit型の定数を作り、unpackしてVectorに戻していました。連接では先頭の要素が最上位ビット側に置かれ、unpackでは最下位ビット側が要素0になるので、順序を戻すreverseが必要でした。

書き換え前

   // str_over: "GAME_OVER"
   Bit#(SizeOf#(Vector#(9, Glyph))) str_over_bits = {
     pg(  2,186, 89,59, 5, 7), // G
     pg( 10,186, 97,59, 5, 7), // A
     pg( 18,186,105,59, 5, 7), // M
     pg( 26,186,113,59, 5, 7), // E
     pg( 34,186,121,59, 5, 7), // _
     pg( 42,186,129,59, 5, 7), // O
     pg( 50,186,137,59, 5, 7), // V
     pg( 58,186,145,59, 5, 7), // E
     pg( 66,186,153,59, 5, 7)  // R
   };
   Vector#(9, Glyph) str_over = reverse(unpack(str_over_bits));

書き換え後

   // str_over: "GAME_OVER"
   Glyph str_over[9] = {
     mkGlyph(  2,186, 89,59, 5, 7), // G
     mkGlyph( 10,186, 97,59, 5, 7), // A
     mkGlyph( 18,186,105,59, 5, 7), // M
     mkGlyph( 26,186,113,59, 5, 7), // E
     mkGlyph( 34,186,121,59, 5, 7), // _
     mkGlyph( 42,186,129,59, 5, 7), // O
     mkGlyph( 50,186,137,59, 5, 7), // V
     mkGlyph( 58,186,145,59, 5, 7), // E
     mkGlyph( 66,186,153,59, 5, 7)  // R
   };

左辺を配列型で宣言すると{ ... }は配列の初期化子として解釈され、先頭に書いた要素が添字0になります。pgとpack、unpack、reverseは要りません。mkGlyphはChatGPT版にもあった構造体のコンストラクタで、そのまま使っています。

生成Verilogは、行番号に由来する内部識別子を正規化するとdiffが0行でした。LUTとFFは増減なしです。定数の並べ方は静的展開の前にしか存在せず、展開後の回路には残りません。


左矢前のブログ 次のブログ右矢

posted by sakurai on September 18, 2026 #1123

二つは同じものの置き方違い

対応を並べると次のようになります。

EN/RDY (BSV) valid/ready (AXI) 意味
送り手の RDY 送り手の valid 送り手に渡すものがある
受け手の RDY 受け手の ready 受け手が受け取れる
接続ルールの AND 両端それぞれの AND 転送の判断
EN 線上に存在しない 判断の結果は各端が自分で使う
RDY は EN に依存してはならない valid は ready に依存してはならない 依存を一方向に保つ

AXI の valid/ready は、EN/RDY の接続ルールにあった AND を両端の内側に移し、EN の線を消したものです。逆に言えば EN/RDY は、両端が持つはずの AND を一か所に集め、その結果を配ることで、二者を超えた合意と衝突の調停を可能にしたものです。

ここで ready という語に注意が要ります。二つの流儀で同じ語が違う意味を持っています。

BSV の RDY は報告です。「呼んでよい状態にある」と上位に知らせるだけで、それ自体は何も起こしません。呼ぶかどうかは上位のルールが決め、RDY が立っていても呼ばれないサイクルは普通にあります。送り手も受け手も同じ形で RDY を出し、両端は対称です。

AXI の ready は決定です。受け手だけが出し、送り手は上位の許可を待たずに valid で勝手に送り、受け手が ready を立てたサイクルで転送が完了します。ready は「受け取れる」という報告であると同時に「このサイクルで受け取る」という受理の決定でもあり、送り手側には ready がなく、対になるのは valid です。

対応表の一行目と二行目がその翻訳です。BSV の受け手の RDY が AXI の ready に当たり、BSV の送り手の RDY は AXI では valid と呼ばれます。BSV で ready と言えば両端が上位に出す報告、AXI で ready と言えば受け手が下す決定、と読み分けてください。

比較

観点 EN/RDY (BSV) valid/ready (AXI)
判断の場所 接続ルールを持つモジュール 両端それぞれ
両端の間 AND と EN の配線 配線のみ、接続ルールの AND は定数になって消える
三者以上の同時性 ルールが複数メソッドを原子的に呼べる 1対1のチャネル単位、複数チャネルの同時性は上位の責任
衝突の調停 bscがスケジューリングで解決し EN に畳み込む fabric や arbiter を別に置く
規約の検査 bscが保証する IP の作り手が守る
他者 IP との結合 相手も EN/RDY を理解する必要がある 線をつなぐだけ
変換 always_ready と always_enabled で valid/ready を作れる EN/RDY に戻すにはトランザクタが要る
遅延要素の挿入 ルールの意味が変わるので慎重になる 両端が独立なのでレジスタスライスを自由に挟める

使い分けは、誰が両端を見渡せるかで決まります。一つの設計の内側では、bscが全てのモジュールを見渡せるので EN/RDY が有利です。複数のメソッドを一度に呼ぶルールが書け、衝突はbscが解き、規約違反は生成物に入りません。設計の境界では、相手の中身が見えないので valid/ready が有利です。両端が自己完結し、間は配線だけで、途中にレジスタスライスを挟んでも両端の設計は変わりません。

BSV で AXI を設計するときの基本方針

ここまでの内容を設計方針として言い直すと一つの文になります。IP の境界は AXI で切り、内側は EN/RDY で書いてbscに任せる、です。

境界とは、両側を別々の人や別々のツールが作る場所のことです。他社 IP との接続、Vivado の block design に置く単位、別々に検証する単位、将来切り離して再利用する単位が境界です。そこでは相手の中身が見えないので、両端が自己完結する valid/ready を使います。BSV 側では、境界のモジュールに synthesize を付け、インタフェースのメソッドを always_ready と always_enabled にして、ポートを素の AXI 信号にします。bsc-contrib のトランザクタはこの境界の定型です。

境界の内側では、モジュールを synthesize で分けても EN/RDY のままで構いません。分けたモジュールの親も BSV であれば、親の中の接続ルールが AND を計算し、bscが両端を見渡しています。EN/RDY が使える範囲は、モジュールの大きさではなく、親をbscが見ているかどうかで決まります。

今回の AxiRegs はこの方針で書かれています。境界には xactor があり、外から見ると素の AXI4-Lite スレーブです。内側の書き込み処理は次の一つの action です。

   Stmt wrseq = seq
      while (True) action
         let a <- pop_o (xactor.o_wr_addr);
         let d <- pop_o (xactor.o_wr_data);
         if (inRange (a.awaddr)) begin
            regs [index (a.awaddr)] <= merge (regs [index (a.awaddr)], d.wdata, d.wstrb);
            xactor.i_wr_resp.enq (AXI4L_Wr_Resp { bresp: AXI4L_OKAY, buser: ? });
         end
         else
            xactor.i_wr_resp.enq (AXI4L_Wr_Resp { bresp: AXI4L_SLVERR, buser: ? });
      endaction
   endseq;
   mkAutoFSM (wrseq);

この action は AW の FIFO から1件、W の FIFO から1件を取り、B の FIFO に1件を入れます。三つの FIFO の RDY が全て立ったサイクルにだけ発火し、発火すれば三つが同時に起こります。AW と W が揃うまで待つ、B が満杯なら待つ、という制御はどこにも書かれていません。三つの RDY の AND をbscが作っているからです。

なぜ BSV の内側を AXI で書かないのか

内側も AXI で統一したほうが一貫している、という考え方は一見正しそうです。しかし、ここでそれを避ける理由は、valid/ready を内側に持ち込むと、bscがやっている三つの仕事を、それぞれ別の IP や別の道具に置き換えて加えなければいけないからです。比較表の三者以上の同時性、衝突の調停、規約の検査の三行がそれです。

三者以上の同時性について:上の wrseq は AW と W と B の三つの FIFO を一つの action で扱い、三つの RDY の AND をbscが作っています。AXI 流では AW と W は独立したチャネルなので、両方が揃ったことを判定して一つの書き込みにまとめる論理を自分で書きます。Xilinx の IP カタログにこの部分を担う汎用の IP はなく、スレーブを書く人がそれぞれのスレーブの中に同じ論理を繰り返し書いています。チャネルが増えれば AND と保持の論理が増え、ルールの原子性という BSV の主要な利点を捨てることになります。

衝突の調停について:二つのルールが同じスレーブを使おうとするとき、EN/RDY ではbscが優先順位を決めて EN に畳み込み、設計者は何も足しません。AXI 流では複数のマスタが一つのスレーブに向かう場合、AXI Interconnect や AXI Crossbar といった調停の IP を別に置きます。その IP はレイテンシを数サイクル足し、面積を消費し、優先順位や ID の幅といった設定項目を持ち、設計の一部として管理する対象になります。BSV の内側なら、調停はbscの出力の一部であり、設定も管理も要りません。

規約の検査について:EN/RDY では、RDY の立っていないメソッドを呼ぶルールは発火しないので、規約違反は生成物に入らず、検査はコンパイル時に終わっています。AXI 流では valid を ready まで保持しているか、その間データを変えていないか、といった規約はbscにとってただの 1 ビットの値の推移で、検査の対象になりません。そこでシミュレーションに AXI Protocol Checker や AXI VIP といった検証用 IP を置き、アサーションで規約違反を捕まえます。検査はシミュレーションで走らせた範囲に限られ、走らせなかった場面の違反は残ります。

まとめると、内側を AXI 流にすると、bscが無償で作っていた結合、調停、検査を、手書きの結合論理、Interconnect IP、Protocol Checker IP として設計に足し、それぞれのレイテンシ、面積、設定、検証範囲を自分で持つことになります。

内側で BSV流EN/RDY を使う理由はこの三つをbscに任せるためであり、一方、境界でAXI流 valid/ready を使う理由は相手を選ばないためです。


左矢前のブログ 次のブログ右矢

posted by sakurai on September 17, 2026 #1122

接続法 2、valid/ready をつなぐ

AXI流のvalid/readyによる接続を図1122.1に示します。

図1122.1
図1122.1 valid/ready の接続

AXI4-Lite の書き込みアドレスチャネルを例にします。スレーブ側のインタフェースは、メソッドに always_ready と always_enabled を付けて EN と RDY を消し、Bool の引数と返り値をそのまま valid と ready の線にします。

interface AxiLiteAW #(numeric type wd_addr);
   (* always_ready, always_enabled, prefix="" *)
   method Action awvalid (Bool awvalid, Bit #(wd_addr) awaddr, Bit #(3) awprot);
   (* always_ready *)
   method Bool   awready;
endinterface

マスタとスレーブをつなぐ mkConnection も、接続法 1 と同じく Connectable のインスタンスが定義するルールです。valid とアドレスをスレーブに渡し、ready をマスタに返しています。

      (* fire_when_enabled, no_implicit_conditions *)
      rule rl_aw;
         s.aw.awvalid (m.m_awvalid, m.m_awaddr, m.m_awprot);
         m.m_awready (s.aw.awready);
      endrule

接続法 1 との違いは、呼んでいるメソッドの側にあります。always_ready は RDY が定数 1 であること、always_enabled は EN が定数 1 で毎サイクル必ず呼ばれることを意味します。発火条件は定数 1 の AND なので定数 1 になり、ルールは毎サイクル無条件に発火します。fire_when_enabled と no_implicit_conditions の属性は、発火条件が本当に定数であることをコンパイラに検査させるためのもので、RDY を持つメソッドが混じっていればコンパイルエラーになります。生成された mkTb.v で、この接続は assign だけになります。mkConnection に AXI 用の特別な動作があるのではなく、接続法 1 と同じ機構で AND を計算した結果、その AND が定数になって消えたものです。

  assign dut$awaddr = master_f_wr_addr$D_OUT[10:3] ;
  assign dut$awprot = master_f_wr_addr$D_OUT[2:0] ;
  assign dut$awvalid = master_f_wr_addr$EMPTY_N ;

AND は両端の中に現れます。マスタ側の FIFO の DEQ と、スレーブ側の FIFO の ENQ です。

  // mkTb.v : マスタ側の xactor
  assign master_f_wr_addr$DEQ = master_f_wr_addr$EMPTY_N && dut$awready ;

  // mkAxiRegs.v : スレーブ側の xactor
  assign awready = xactor_f_wr_addr$FULL_N ;
  assign xactor_f_wr_addr$D_IN = { awaddr, awprot } ;
  assign xactor_f_wr_addr$ENQ = awvalid && xactor_f_wr_addr$FULL_N ;

接続法 1 で mkTop にあった AND が、接続法 2 では両端の内側に一つずつ複製されています。それ以外は同じで、valid は送り手の FIFO の EMPTY_N、ready は受け手の FIFO の FULL_N です。

この変換を行っているのが bsc-contrib のトランザクタです。外側のメソッドを always_ready と always_enabled にして EN/RDY を消し、内側で FIFO の ENQ を valid && FULL_N と書いて AND を自分の中に置きます。BSV の内部は EN/RDY のまま、境界だけを valid/ready にする、というアダプタです。


左矢前のブログ 次のブログ右矢

posted by sakurai on September 16, 2026 #1121

接続法 1、EN/RDY を mkConnection でつなぐ

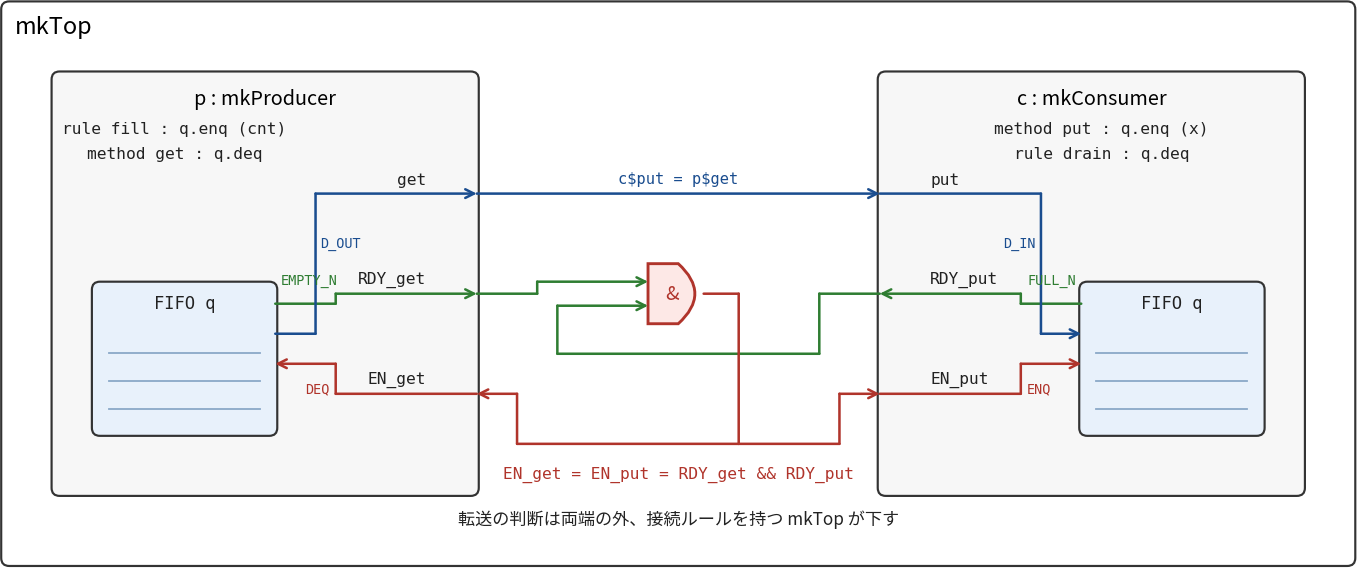
BSV流のEN/RDYによる接続を図1121.1に示します。

図1121.1
図1121.1 EN/RDY の接続

送り手 mkProducer は FIFO からの取り出しを Get で、受け手 mkConsumer は FIFO への書き込みを Put で公開し、最上位 mkTop が mkConnection でつなぎます。

package EnRdy;

import GetPut :: *;
import FIFOF  :: *;
import Connectable :: *;

// 送り手 : FIFO から取り出す Get
(* synthesize *)
module mkProducer (Get #(Bit #(8)));
   FIFOF #(Bit #(8)) q <- mkFIFOF;
   Reg #(Bit #(8)) cnt <- mkReg (0);

   rule fill;
      q.enq (cnt);
      cnt <= cnt + 1;
   endrule

   method ActionValue #(Bit #(8)) get;
      q.deq;
      return q.first;
   endmethod
endmodule

// 受け手 : FIFO に入れる Put
(* synthesize *)
module mkConsumer (Put #(Bit #(8)));
   FIFOF #(Bit #(8)) q <- mkFIFOF;

   rule drain;
      q.deq;
   endrule

   method Action put (Bit #(8) x);
      q.enq (x);
   endmethod
endmodule

// 最上位 : mkConnection でつなぐ
(* synthesize *)
module mkTop (Empty);
   Get #(Bit #(8)) p <- mkProducer;
   Put #(Bit #(8)) c <- mkConsumer;
   mkConnection (p, c);
endmodule

endpackage

bsc が生成した mkTop.v のモジュール本体です。

module mkTop(CLK,
	     RST_N);
  input  CLK;
  input  RST_N;

  // ports of submodule c
  wire [7 : 0] c$put;
  wire c$EN_put, c$RDY_put;

  // ports of submodule p
  wire [7 : 0] p$get;
  wire p$EN_get, p$RDY_get;

  // submodule c
  mkConsumer c(.CLK(CLK),
	       .RST_N(RST_N),
	       .put(c$put),
	       .EN_put(c$EN_put),
	       .RDY_put(c$RDY_put));

  // submodule p
  mkProducer p(.CLK(CLK),
	       .RST_N(RST_N),
	       .EN_get(p$EN_get),
	       .get(p$get),
	       .RDY_get(p$RDY_get));

  // submodule c
  assign c$put = p$get ;
  assign c$EN_put = p$RDY_get && c$RDY_put ;

  // submodule p
  assign p$EN_get = p$RDY_get && c$RDY_put ;
endmodule  // mkTop

mkConnection は Connectable 型クラスのメソッドで、インタフェースの組ごとにインスタンスが定義されています。Get と Put の組のインスタンスは、本質的に次のルール一つです。

instance Connectable #(Get #(a), Put #(a));
   module mkConnection #(Get #(a) g, Put #(a) p) (Empty);
      rule connect;
         let x <- g.get;
         p.put (x);
      endrule
   endmodule
endinstance

ルールの発火条件は、呼んでいるメソッド全部の RDY の AND です。get と put は RDY を持つ普通のメソッドなので、この接続ルールは mkTop の中の AND ゲート一つになりました。両端の RDY を集めて AND を取り、その結果を EN として両端に返しています。両端の中では、RDY は FIFO の状態そのもので、EN はそのまま FIFO の制御になります。mkProducer.v と mkConsumer.v の該当行です。

  // mkProducer.v
  assign get = q$D_OUT ;
  assign RDY_get = q$EMPTY_N ;
  assign q$DEQ = EN_get ;

  // mkConsumer.v
  assign RDY_put = q$FULL_N ;
  assign q$D_IN = put ;
  assign q$ENQ = EN_put ;

両端の判断は外の EN に委ねられ、EN で「今回は転送」と言われて動きます。


左矢前のブログ 次のブログ右矢

posted by sakurai on September 15, 2026 #1120

バックプレッシャの二つの流儀、BSV の EN/RDY と AXI の valid/ready

バックプレッシャは、受け手が受け取れないときに送り手を待たせる仕組みです。Bluespec SystemVerilog のメソッド呼び出しと AXI のチャネルは、どちらもバックプレッシャを持つ点対点の転送ですが、転送するかどうかの判断をどこで下すかが違います。BSV は両端の外側で判断し、AXI は両端の内側でそれぞれ判断します。この違いを、両方の思想、それぞれの接続法、生成された Verilog、そして比較の順に見ていきます。

BSV の思想、ルールが判断する

BSV のメソッドは、呼ばれる側が RDY を出し、呼ぶ側が EN を返す約束で動きます。ここで注意すべきは、点対点の両方の点はいずれも呼ばれる側ということです。呼ぶ側は点の外にいます。RDY は「今呼んでよい」という呼ばれる側の状態で、EN は「今呼ぶ」という呼ぶ側の決定です。EN を立ててよいのは RDY が立っているときだけで、RDY は EN に依存してはいけません。依存は RDY から EN への一方向です。

判断を下すのはルールです。ルールは複数のモジュールの複数のメソッドを一度に呼び、呼ぶメソッド全部の RDY が立っているときだけ発火し、発火すれば全部が同じサイクルに起こり、発火しなければ何も起こりません。この原子性を実現するには、関係する全員の RDY を一か所に集めて AND を取る場所が必要で、それがルールです。EN はその AND の結果を各メソッドに配る信号です。

EN にはもう一つの情報が畳み込まれています。同じサイクルに衝突する他のルールとの優先順位です。二つのルールが同じレジスタを書こうとすれば、どちらが勝つかをコンパイラが決め、負けた側の EN は落ちます。これは設計全体を見渡せるコンパイラだけが決められることです。

そしてこの約束はコンパイラが検査します。RDY の立っていないメソッドを呼ぶルールはそもそも発火しないので、準備のできていない相手を呼ぶ誤りは生成物に入りません。EN/RDY は、コンパイラが両端を見渡せる一つの設計の中で、原子的な合成を機械的に保証するための約束です。

AXI の思想、両端が判断する

AXI のチャネルは、送り手が valid を出し、受け手が ready を出し、両方が立っているクロックの立ち上がりで1件が渡ります。valid は「渡すものがある」という送り手の状態、ready は「受け取れる」という受け手の状態です。どちらも自分の状態の表明です。点対点の転送において、送信点と受信点のみがあり、その外にロジックはありません。

転送するかどうかは両端がそれぞれ判断します。送り手は valid と ready の AND を自分で計算して自分の出口を進め、受け手も同じ AND を自分で計算して自分の入口に取り込みます。両端の間にあるのは配線だけです。AND は両端の内側に一つずつ、合わせて二つあり、同じ値を計算しています。

この構造が成り立つ条件が、valid を ready に依存させてはいけないという規則です。両端が互いの状態を見て自分の AND を作るので、両方が相手に依存すると組み合わせループになります。そこで valid は自分の状態だけから決め、ready の側だけに相手を見ることを許して、依存を一方向に保ちます。EN/RDY の一方向の規則と同じ役割を、valid/ready では ready から valid への禁止が担っています。

判断を両端に閉じ込めた効果は、接続に第三者が要らなくなることです。どこの誰が作った IP でも、線をつなげば結合できます。fabric はルーティングとマルチプレクスに専念でき、転送の可否には関与しません。AXI は、互いの中身を知らない IP どうしを配線だけでつなぐための約束です。


左矢前のブログ 次のブログ右矢

posted by sakurai on September 14, 2026 #1119

10. 順序の正しい手順、B を受け取ってから読む

図1119.1
図1119.1

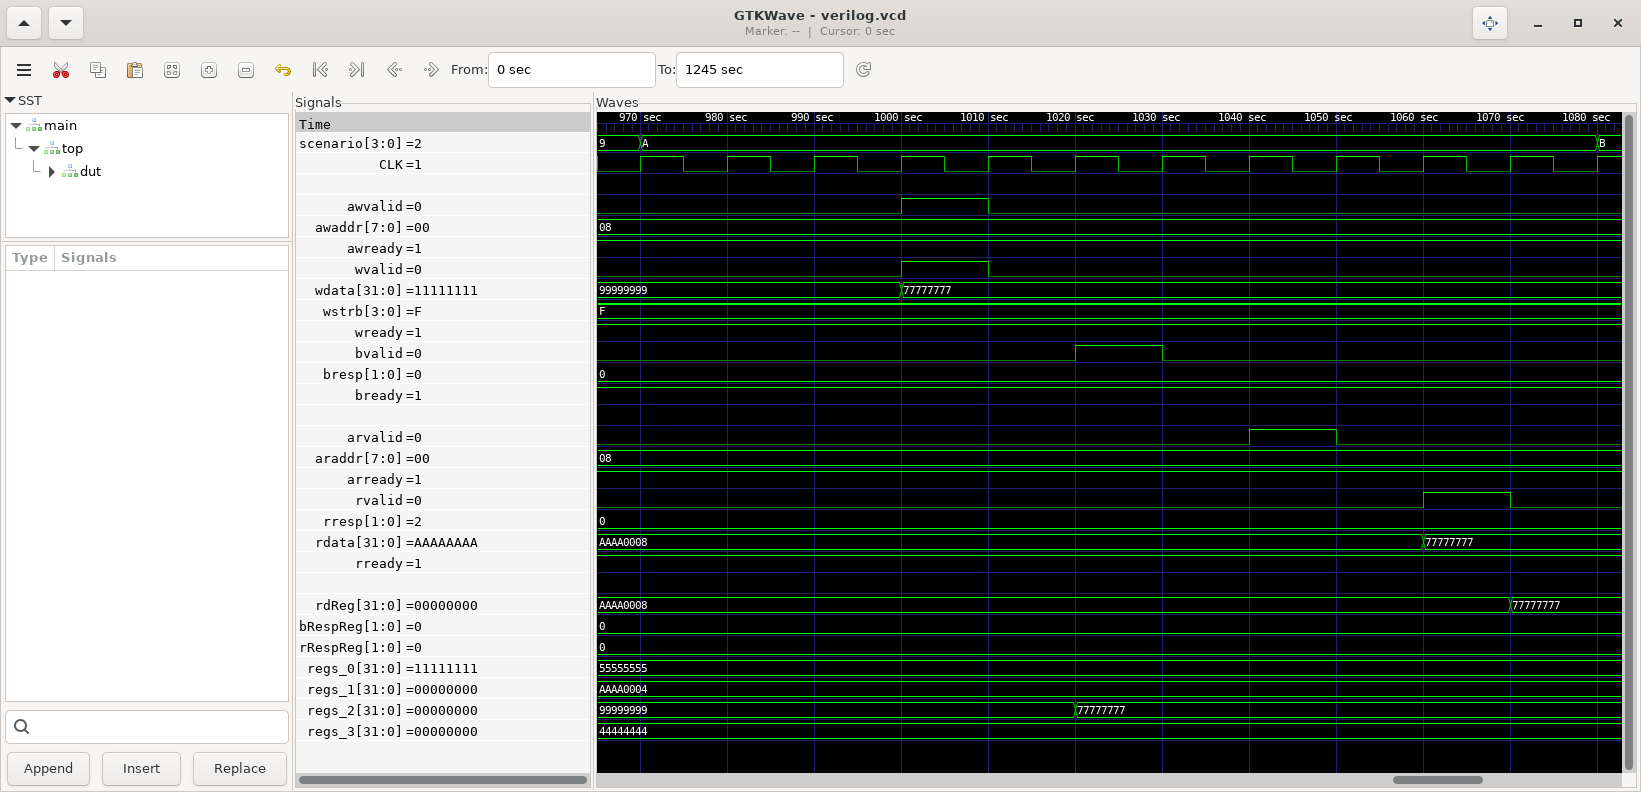
場面 9 と同じ 0x08 に、今度は順序を守って書いて読みます。1000 で AW と W を出し、1000 で成立します。1020 で B が返り、getB がその握手で受け取ります。regs_2 が 77777777 になるのも 1020 です。getB の次の文が putAR なので、1030 のサイクルに文が実行されて 1040 から arvalid が立ち、1060 の R で 77777777 が返って 1070 で rdReg に入ります。

書いた値を読みたければ B を受け取ってから AR を出す、という責任はマスタにあり、以下のコードのようにgetB の後に putAR を置くことがその手順の記述です。場面 9 との違いは AR を出す位置だけで、スレーブは何も変わっていません。

   Stmt s10 = seq
      mark (10, "RAW ordered: write, wait B, then read");
      par
         putAW (8'h08);
         putW  (32'h77777777, 4'hF);
      endpar
      getB;                                      // ここで書き込みの完了が確定する
      putAR (8'h08);                             // B を受け取った次の文で AR
      getR;                                      // 77777777
   endseq;

putAW
putW → getB → putAR → getR

11. エラー応答

図1119.2
図1119.2

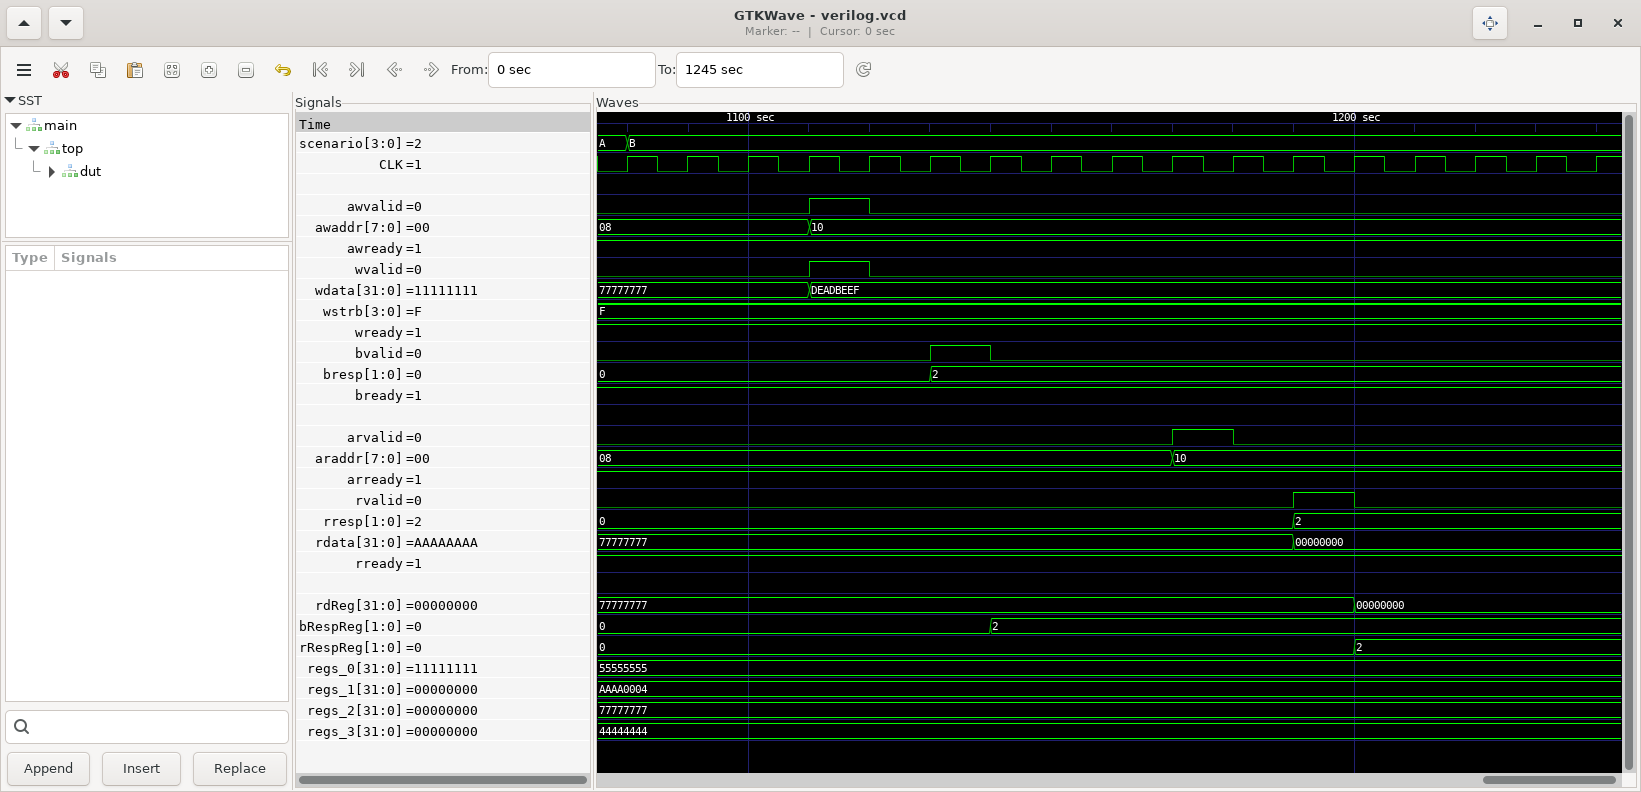
範囲外の 0x10 に書きます。握手は通常どおり 1110 で成立し、1130 の B で bresp が 2、SLVERR になります。regs はどれも変わりません。1170 で 0x10 を読むと、1190 の R で rresp が 2、rdata は 0 です。エラーは握手の失敗として現れるのではなく、握手は成立させたうえで応答コードで伝える、というのが AXI の流儀です。

場面と見どころの対応

場面 出すもの 見るもの
1 AW と W を同時 三つの握手が独立に成立、B は処理の後
2 AR rdata は rvalid と同時にだけ有効
3 W の後に AW スレーブは揃うまで動かない
4 AW の後に W 同上、順序に決まりはない
5 AW を3件連続 awready が落ちる、マスタは保持、B は順に返る
6 bready を下げて書く bvalid と bresp が保持される
7 rready を下げて読む rvalid と rdata が保持される
8 AW、W、AR を同時 読み書きが並行に進む
9 同じ番地へ書きながら読む 古い値が返る、順序は保証されない
10 書いて B を受け取ってから読む 新しい値が返る、順序はマスタの責任
11 範囲外の番地 握手は成立、応答コードで SLVERR

左矢前のブログ 次のブログ右矢


ページ: